AI 에이전트의 치명적인 건망증을 해결하는 Mem0 장기 기억 아키텍처 완벽 가이드
AI 에이전트의 치명적인 건망증을 해결하는 Mem0 장기 기억 아키텍처 완벽 가이드
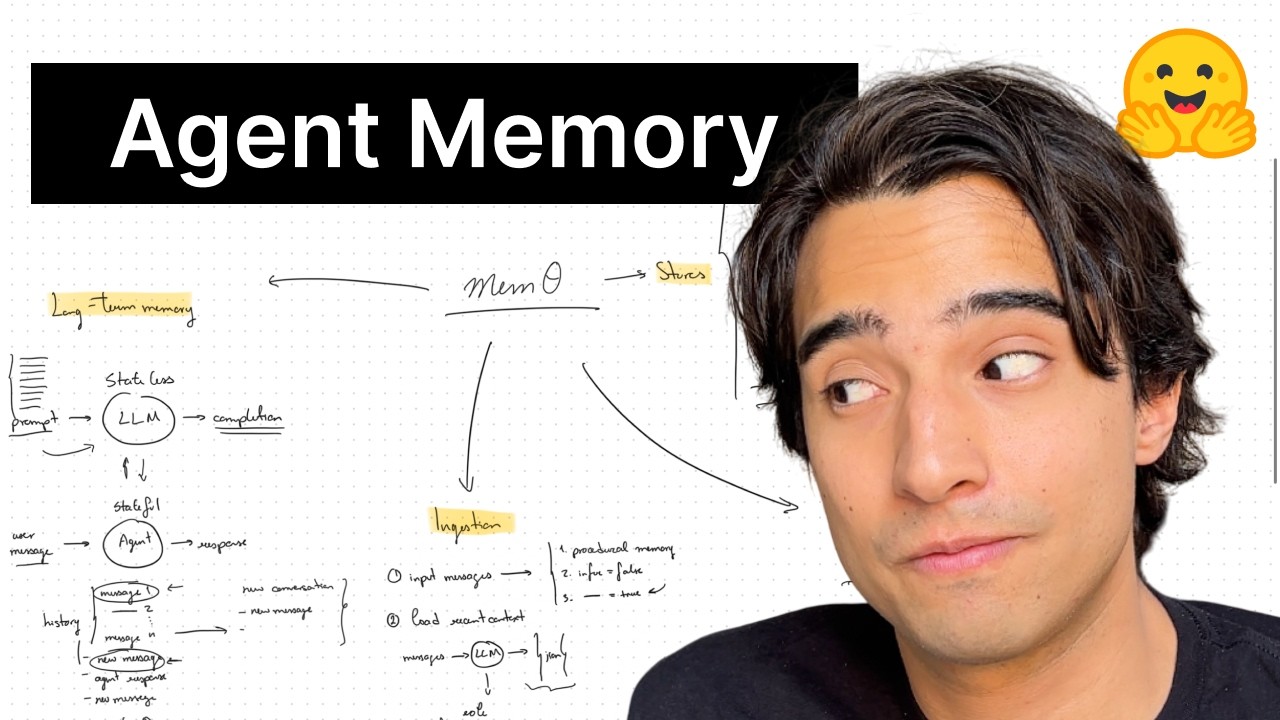
📌 한 줄 요약: 대화형 기억의 한계를 극복하고 세션 간 영속적인 지식을 유지하기 위한 AI 에이전트 장기 기억 시스템(Mem0)의 아키텍처와 작동 원리, 로컬 구현 방안을 심층적으로 살펴본다.
원본 영상
이 글은 위 영상의 내용을 정리·재구성한 것이다. 원문의 맥락과 뉘앙스는 영상에서 직접 확인할 수 있다.
우리가 매일 사용하는 대화형 AI는 대단히 영리해 보이지만, 사실 새로고침 버튼을 누르는 순간 지금까지 나눈 모든 대화를 깨끗하게 잊어버리는 치명적인 건망증을 가지고 있다. 일상적인 질의응답을 넘어 사용자의 미묘한 취향이나 과거의 맥락을 스스로 학습하고 기억하는 진짜 나만의 AI 비서를 만들기 위해서는, 단순한 대화 기록을 넘어선 구조화된 장기 기억 시스템이 필수적이다. 이 글에서는 오픈소스 메모리 레이어인 Mem0의 구조를 바탕으로 에이전트가 어떻게 기억을 저장하고 활용하는지 그 메커니즘을 상세히 해부한다.
💡 주요 내용 및 핵심 인사이트
1. 에이전트 장기 기억(Long-Term Memory) 시스템의 필요성 ⏱️ [00:56]
대형 언어 모델(LLM)은 기본적으로 상태가 없는(stateless) 머신이므로, 이전 프롬프트나 응답을 기억하지 못한다. 기존의 '대화형 기억(Conversational Memory)'은 단순히 전체 대화 히스토리를 프롬프트에 동봉하여 맥락을 유지하는 방식으로, 새로운 대화 세션이 시작되면 이전 내용을 전혀 기억하지 못한다. 예를 들어 일반적인 챗봇과 대화하다가 "내가 누구인지, 내가 무엇을 좋아하는지" 같은 개인적인 내용을 입력하면 대화 중에는 이를 기억하고 답변하지만, 새로고침을 하고 다시 물어보면 전혀 기억하지 못하는 한계가 드러난다 (출처: 파이썬으로 장기기억 AI Agent 만들기, 다비드스튜디오 dabidstudio). 반면 장기 기억 에이전트는 사용자가 "나는 다비드고 라면을 좋아해"라고 입력하면 이를 메모리에 저장하고, 새로운 채팅이나 세션에서도 취향이나 이름을 기억하여 마치 나에게 맞춤형으로 발전을 하는 AI 비서처럼 작동한다 (출처: 파이썬으로 장기기억 AI Agent 만들기, 다비드스튜디오 dabidstudio). 따라서 사용자에 대한 정보, 세계에 대해 학습한 사실, 에이전트 자체의 경험 등을 여러 대화에 걸쳐 영속적으로 유지하려면 대화 세션과 분리된 독립적인 '장기 기억 시스템(Long-Term Memory System)'이 반드시 필요하다.
2. Mem0가 사용하는 3가지 핵심 저장소(Stores) ⏱️ [04:31]
Mem0는 장기 기억을 안정적으로 관리하기 위해 기능이 분화된 세 가지 핵심 저장소를 유기적으로 결합하여 사용한다.
- 메인 기억 저장소 (Main Memory Store): 실제 기억 내용(예: "사용자는 채식 레스토랑을 선호함")과 관련 메타데이터(생성일, 소유자, 해시, 키워드 검색을 위한 표제어 형태, 만료일 등)를 저장하는 벡터 데이터베이스(Vector DB)다.
- 엔티티 기억 저장소 (Entity Store): 메인 기억에서 장소, 고유 명사, 인물 등의 개체(Entity)를 추출하여 별도로 저장하는 벡터 데이터베이스다. 특정 엔티티(예: 프랑스의 파리)와 연관된 여러 기억들을 묶어 효율적으로 검색할 수 있게 돕는다.
- SQLite 데이터베이스: 벡터 저장소 변경 이력을 추적하는 로깅 시스템 역할과 함께, 파이프라인에 전달된 가장 최근의 메시지 10개를 유지하여 새로운 기억 생성 시 대명사 등의 맥락을 파악할 수 있도록 지원한다.
3. 기억 유입(Ingestion) 파이프라인과 LLM 기반 추출 ⏱️ [08:07]
에이전트의 작업 턴(turn)이 끝날 때마다 생성된 메시지들이 유입 파이프라인으로 전달되며, 램제로는 유저의 인터션에서 유저 어시스턴트로의 페어에서 어떤 것을 뽑아낼 것인지를 추출하는 익스프레션 페이스(Expression Phase)와 데이터베이스 적제를 담당하는 업데이트 페이스(Update Phase) 등 두 가지 핵심 단계로 구성된다 (출처: LLM 에이전트는 어떻게 사용자를 기억할까? Mem0의 장기 메모리 구조 분석, LLM Study). 유입 방식에는 절차적 기억(Procedural memory), 단순 임베딩 후 저장 (infer=false), 그리고 LLM 기반 추출 파이프라인 가동(infer=true) 등 3가지가 존재한다. infer=true 설정 시, LLM은 프롬프트(역할, 사용자 요약, 입력 메시지, 관련 기억, 최근 10개 메시지 등)를 바탕으로 구조화된 JSON 형태의 핵심 기억을 추출한다. 추출된 기억은 메인 벡터 저장소에 추가되며, 중복 제거(Deduplication)를 위해 해시값 비교와 키워드 검색을 위한 표제어(Lemmatized version) 생성이 함께 이루어진다.
4. 복합 점수 기반의 기억 검색(Retrieval) 시스템 ⏱️ [15:43]
검색은 에이전트의 명시적 도구 호출(Explicit tool search)이나 매 에이전트 턴마다의 자동 검색(Automatic retrieval) 형태로 수행된다. 사용자가 나에 대한 정보를 입력하면 메모리에 추가하는 도구를 활용하면서 답변을 제공하는 방식처럼 에이전트는 필요할 때 기억을 꺼내 쓴다 (출처: 파이썬으로 장기기억 AI Agent 만들기, 다비드스튜디오 dabidstudio). 쿼리가 들어오면 먼저 동일한 임베딩 모델을 통해 벡터 검색(Nearest Neighbors)을 수행하여 기본 풀(Top-K의 약 4배수 또는 최소 60개)을 확보한다. 확보된 기본 풀은 세 가지 점수 체계를 합산하여 재랭킹(Re-ranking)된다.
- 벡터 유사도 점수: 0에서 1 사이의 값
- 키워드 매칭 점수 (BM25): 쿼리와 기억 간의 단어 중복(Word overlap)을 측정하여 0에서 1 사이의 값으로 변환
- 엔티티 부스트 (Entity Boost): 엔티티 데이터베이스 검색 결과를 활용하며, 해당 엔티티에 연관된 기억의 수가 적을수록 더 높은 가중치(최대 0.5)를 부여
최종적으로 이 세 점수를 합산하고 정규화하여 가장 관련성이 높은 상위 K개의 기억을 에이전트 컨텍스트에 주입한다.
5. 오픈소스 모델을 활용한 로컬 구축 방안 ⏱️ [15:41]
클라우드 기반 모델 외에도 허깅페이스(Hugging Face)의 오픈소스 모델을 활용해 장기 기억 시스템을 완전히 로컬 환경에서 구축할 수 있다. 추출용 LLM으로는 상대적으로 단순한 작업이므로 10억~120억 파라미터 규모의 소형 모델(예: 큐원(Qwen) 계열 또는 라마(Llama) 계열)을 권장한다. 임베딩 모델은 허깅페이스의 Feature Extraction 필터 및 MTEB(Massive Text Embedding Benchmark) 순위를 참고하여 영어, 다국어 또는 도메인 특화(예: 의료 등) 성능이 뛰어난 모델을 선택할 수 있다. 장기적인 정확도 향상을 위해 소형 모델을 목적에 맞게 파인튜닝(Fine-tuning)하는 방법도 유효하다.
📚 주요 용어 정리 및 설명
- 대화형 기억 (Conversational Memory): 현재 세션 내에서 LLM이 문맥을 유지할 수 있도록 전체 대화 히스토리를 프롬프트에 함께 전달하는 방식이다. 세션이 종료되면 유지되지 않는다.
- 장기 기억 (Long-Term Memory): 대화 세션과 독립적으로 외부 저장소에 영속적으로 저장되어, 여러 대화와 여러 에이전트 간에 공유될 수 있는 사용자 및 에이전트의 핵심 지식 시스템이다.
- 표제어 추출 (Lemmatization): 단어의 원형이나 기본 형태를 추출하는 과정으로, Mem0에서는 키워드 검색의 정확도를 높이기 위해 기억 문장과 쿼리에 활용한다.
- 재랭킹 (Re-ranking): 초기 벡터 검색으로 대량으로 수집된 후보 기억 풀을 키워드 매칭, 엔티티 부스트 등 다양한 알고리즘으로 다시 평가하여 가장 적합한 순서로 재정렬하는 과정이다.
📎 참고 영상
- 파이썬으로 장기기억 AI Agent 만들기 (다비드스튜디오 dabidstudio): https://www.youtube.com/watch?v=DTVqC8IysiY
- LLM 에이전트는 어떻게 사용자를 기억할까? Mem0의 장기 메모리 구조 분석 (LLM Study): https://www.youtube.com/watch?v=tejs5VaI6oE
에이전트가 진정한 개인화 비서로 진화하기 위해서는 단순한 일회성 대화의 틀을 깨고 영속적인 지식을 축적하는 아키텍처가 뒷받침되어야 한다. Mem0가 제시하는 구조화된 저장소와 정교한 검색 파이프라인은 앞으로 LLM 애플리케이션의 한계를 뛰어넘는 강력한 돌파구가 되어줄 것이다.
"만약 에이전트가 자신에 대해, 그리고 세상에 대해 학습한 내용을 대화 전반에 걸쳐 기억하기 원한다면, 여러분에게는 에이전트 메모리 시스템이 필요하다."