컴퓨터가 문장을 이해하는 과정: 토큰화부터 벡터화, 그리고 임베딩까지
컴퓨터가 문장을 이해하는 과정: 토큰화부터 벡터화, 그리고 임베딩까지
📌 한 줄 요약: 컴퓨터가 텍스트 데이터를 이해하도록 처리하는 자연어 처리의 기초 단계인 토큰화, 벡터화, 임베딩의 정의와 차이점을 명확히 파악한다.
원본 영상 · 오늘코드todaycode
이 글은 위 영상의 내용을 정리·재구성한 것이다. 원문의 맥락과 뉘앙스는 영상에서 직접 확인할 수 있다.
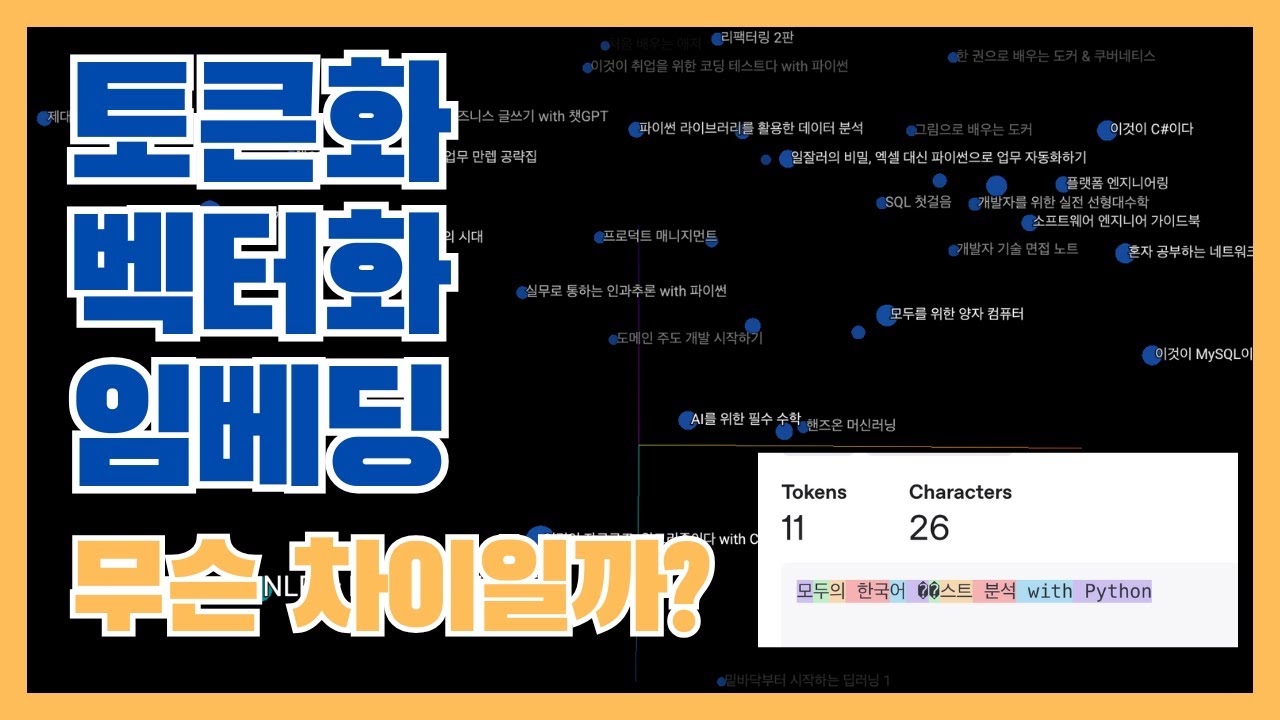
인공지능과 대화할 때 우리는 너무나 당연하게 문장을 입력하지만, 사실 컴퓨터는 인간의 언어를 단 한 글자도 그대로 받아들이지 못한다. 생성형 AI나 대형 언어 모델(LLM)에 텍스트로 질문을 입력하더라도 내부적으로는 복잡한 숫자 연산을 거쳐 처리된다. 이 글에서는 텍스트가 어떤 단계를 거쳐 컴퓨터의 언어인 숫자로 변환되는지, 그 핵심 과정인 토큰화와 벡터화 그리고 임베딩의 원리를 차근차근 살펴본다.
💡 주요 내용 및 핵심 인사이트
1. 컴퓨터가 텍스트 데이터를 숫자로 변환해야 하는 이유 ⏱️ [25]
컴퓨터는 인간의 언어를 직접 이해할 수 없으므로, 모든 텍스트 데이터는 내부 연산을 위해 숫자로 변환되어야 함. 생성형 AI나 대형 언어 모델(LLM)에 텍스트로 질문을 입력하더라도 내부적으로는 숫자로 처리됨.
2. 토큰화(Tokenization)의 개념과 단위 ⏱️ [71]
토큰화는 주어진 텍스트를 분석 목적에 맞게 의미를 가진 최소 단위인 토큰으로 분해하는 과정임. 띄어쓰기, 단어, 형태소, 서브워드 등 다양한 단위로 나눌 수 있으며, 기계가 처리할 수 있는 기본 단위를 제공함. 한국어의 경우 조사와 어미가 존재하므로 형태소 분석기나 서브워드 토크나이저를 활용하는 것이 의미를 살리는 데 유리함.
3. 벡터화(Vectorization)와 단어 가방(BoW), TF-IDF ⏱️ [108]
벡터화는 분해된 토큰 단위를 숫자 벡터로 표현하여 기계가 연산할 수 있게 만드는 과정임. 백오브 워드(BoW)는 단어의 등장 여부나 빈도를 단순하게 표현하며, TF-IDF는 문서 내 단어의 상대적 중요도에 가중치를 부여함. 벡터화된 데이터는 0인 값이 많은 희소 벡터(Sparse Vector)의 형태를 띰.
4. 임베딩(Embedding)과 고차원 공간에서의 의미 투영 ⏱️ [122]
임베딩은 단어나 문장의 문맥적 의미와 유사도를 반영하여 다차원 공간에 텍스트를 밀집 벡터(Dense Vector)로 구축하는 과정임. 0이 많은 희소 벡터와 달리 빽빽하게 숫자가 차 있는 밀집 벡터 형태를 가지며, 텍스트의 잠재적 의미를 벡터 공간에 투영함. 텐서플로우 임베딩 프로젝터 등을 활용해 시각화할 수 있으며, 단어 간의 거리와 각도를 통해 의미적 유사도를 파악할 수 있음.
5. 유사도 계산: 코사인 유사도와 유클리드 거리 ⏱️ [200]
다차원 공간에 투영된 단어들의 유사도를 측정할 때 유클리드 거리(직선 거리)와 코사인 유사도(각도 기준)를 사용함. 코사인 유사도는 방향이 같은지를 기준으로 판단하므로, 트랜스포머 및 GPT 등의 모델에서 단어 간 거리 및 유사도를 계산할 때 주로 활용됨.
6. 실습을 통한 도서 제목 임베딩 및 벡터 DB 활용 ⏱️ [610]
OpenAI의 API(text-embedding-3-small 모델 등)를 활용하여 실제 도서 제목 데이터를 밀집 벡터로 변환하는 실습을 진행함. 고차원 임베딩 결과를 PCA 등의 차원 축소 기법을 통해 2차원 또는 3차원으로 축소하여 시각적으로 유사한 도서들을 확인할 수 있음. 매번 비용을 지불하고 임베딩을 수행하는 대신, 생성된 임베딩 결과를 벡터 데이터베이스(Vector DB)에 저장하여 유사도 검색 및 RAG 등에 활용함.
📚 주요 용어 정리 및 설명
- 토큰화 (Tokenization): 텍스트를 기계가 처리할 수 있는 최소 의미 단위(단어, 형태소, 서브워드 등)로 쪼개는 과정.
- 벡터화 (Vectorization): 토큰화된 텍스트를 컴퓨터가 연산할 수 있도록 숫자 데이터로 변환하는 과정.
- 임베딩 (Embedding): 텍스트의 문맥적 의미와 관계를 다차원 공간에 밀집 벡터 형태로 매핑하여 단어 간 유사도를 계산할 수 있게 만드는 기술.
- TF-IDF: 단어 빈도(TF)와 역문서 빈도(IDF)를 곱한 값으로, 특정 문서에서 해당 단어가 얼마나 중요한 의미를 가지는지 가중치를 부여하는 기법.
- 코사인 유사도 (Cosine Similarity): 두 벡터 간의 각도를 이용하여 텍스트의 방향성이 얼마나 일치하는지 측정함으로써 의미적 유사도를 구하는 방식.
- 벡터 데이터베이스 (Vector DB): 임베딩을 통해 생성된 고차원 벡터 데이터를 효율적으로 저장하고 유사도 검색을 수행하기 위한 데이터베이스.
자연어 처리의 흐름은 단순한 텍스트 쪼개기를 넘어 문맥적 의미를 다차원 공간에 투영하고, 이를 데이터베이스에 담아 실무에 활용하는 단계로 확장된다. 이론으로 이해한 토큰화와 임베딩의 개념을 직접 API 호출과 벡터 검색 실습에 적용해 본다면 생성형 AI를 다루는 시야가 한층 더 넓어질 것이다.
"단순 빈도를 넘어서 텍스트의 잠재적인 의미를 벡터 공간에 투영해 준다."